Schema Diagram and Graph Statistics
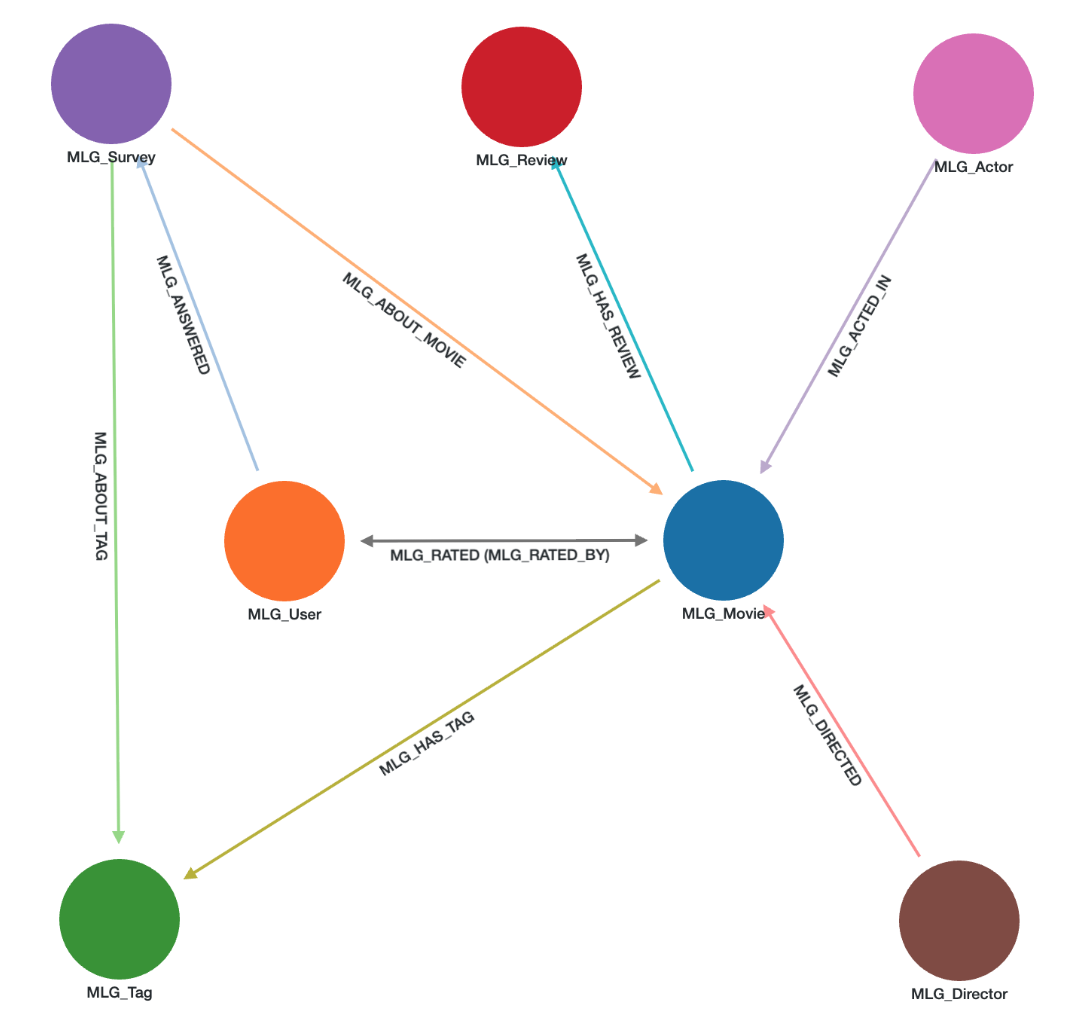
Node Statistics
| Node Label | Count |
|---|---|
| Actor | 122,974 |
| Director | 33,592 |
| Movie | 84,661 |
| Review | 2,623,824 |
| Survey | 58,903 |
| Tag | 1,094 |
| User | 247,389 |
Edge Statistics
| Relationship | Count |
|---|---|
| (:Survey)-[:ABOUT_MOVIE]-(:Movie) | 58,903 |
| (:Survey)-[:ABOUT_TAG]-(:Tag) | 58,903 |
| (:Actor)-[:ACTED_IN]-(:Movie) | 371,629 |
| (:User)-[:ANSWERED]-(:Survey) | 58,903 |
| (:Director)-[:DIRECTED]-(:Movie) | 84,294 |
| (:Movie)-[:HAS_REVIEW]-(:Review) | 2,623,824 |
| (:Movie)-[:HAS_TAG]-(:Tag) | 212,092 |
| (:User)-[:RATED]-(:Movie) | 28,454,882 |
Data Loading Overview
Overview
We mainly used the TigerGraph GSQLShell to import the data.
Creating Graph Schema
Use the GSQLShell tool on the TigerGraph to create vertex and edge types. For RATED
edge, we will also create its reverse edge so that we can run Louvain Community detection query.
CREATE VERTEX MLG_Movie (
  PRIMARY_ID item_id UINT,
  title STRING,
  avgRating FLOAT,
  imdbId STRING,
  directedBy STRING,
  starring STRING
) WITH primary_id_as_attribute="true"

CREATE VERTEX MLG_User (
  PRIMARY_ID user_id UINT
) WITH primary_id_as_attribute="true"

CREATE VERTEX MLG_Tag (
  PRIMARY_ID tag_id UINT,
  tag STRING
) WITH primary_id_as_attribute="true"

CREATE VERTEX MLG_Review (
  PRIMARY_ID review_id UINT,
  text STRING
) WITH primary_id_as_attribute="true"

CREATE VERTEX MLG_Survey (
  PRIMARY_ID survey_id UINT,
  score INT
) WITH primary_id_as_attribute="true"

CREATE VERTEX MLG_Director (
  PRIMARY_ID name STRING
) WITH primary_id_as_attribute="true"

CREATE VERTEX MLG_Actor (
  PRIMARY_ID name STRING
) WITH primary_id_as_attribute="true"

CREATE DIRECTED EDGE MLG_RATED (
  FROM MLG_User, TO MLG_Movie,
  DISCRIMINATOR (rating_id UINT),
  rating FLOAT
) WITH REVERSE_EDGE="MLG_RATED_BY"

CREATE DIRECTED EDGE MLG_HAS_TAG (
  FROM MLG_Movie, TO MLG_Tag,
  tag_count UINT
)

CREATE DIRECTED EDGE MLG_HAS_REVIEW (
  FROM MLG_Movie, TO MLG_Review
)

CREATE DIRECTED EDGE MLG_ANSWERED (
  FROM MLG_User, TO MLG_Survey
)

CREATE DIRECTED EDGE MLG_ABOUT_MOVIE (
  FROM MLG_Survey, TO MLG_Movie
)

CREATE DIRECTED EDGE MLG_ABOUT_TAG (
  FROM MLG_Survey, TO MLG_Tag
)

CREATE DIRECTED EDGE MLG_DIRECTED (
  FROM MLG_Director, TO MLG_Movie
)

CREATE DIRECTED EDGE MLG_ACTED_IN (
  FROM MLG_Actor, TO MLG_Movie
)

CREATE GRAPH mlgenome (
  MLG_Movie, MLG_User, MLG_Tag, MLG_Review, MLG_Survey, MLG_Director, MLG_Actor,
  MLG_RATED, MLG_RATED_BY, MLG_HAS_TAG, MLG_HAS_REVIEW, MLG_ANSWERED,
  MLG_ABOUT_MOVIE, MLG_ABOUT_TAG, MLG_DIRECTED, MLG_ACTED_IN
)
Import Data
For data import, we will define two import jobs on Tigergraph, and run the import jobs to load data.
USE GRAPH mlgenome

CREATE LOADING JOB load_mlgenome_vertices FOR GRAPH mlgenome {
  DEFINE FILENAME f_metadata       = "/datasets/prop_datasets/movielens/genome_2021/raw/metadata.json";
  DEFINE FILENAME f_rating_users   = "/datasets/prop_datasets/movielens/genome_2021/raw/ratings.json";
  DEFINE FILENAME f_tags           = "/datasets/prop_datasets/movielens/genome_2021/raw/tags.json";
  DEFINE FILENAME f_reviews        = "/datasets/prop_datasets/movielens/genome_2021/raw/review_with_id_tigergraph.json";
  DEFINE FILENAME f_surveys        = "/datasets/prop_datasets/movielens/genome_2021/raw/surveys_id.json";
  DEFINE FILENAME f_directors      = "/datasets/prop_datasets/movielens/genome_2021/raw/director_vertices_tigergraph.json";
  DEFINE FILENAME f_actors         = "/datasets/prop_datasets/movielens/genome_2021/raw/actor_vertices_tigergraph.json";

  LOAD f_metadata
    TO VERTEX MLG_Movie VALUES (
      $"item_id", $"title", $"avgRating", $"imdbId",
      $"directedBy", $"starring"
    )
    USING JSON_FILE="true";

  LOAD f_rating_users
    TO VERTEX MLG_User VALUES ($"user_id")
    USING JSON_FILE="true";

  LOAD f_tags
    TO VERTEX MLG_Tag VALUES ($"id", $"tag")
    USING JSON_FILE="true";

  LOAD f_reviews
    TO VERTEX MLG_Review VALUES ($"review_id", $"txt")
    USING JSON_FILE="true";

  LOAD f_surveys
    TO VERTEX MLG_User VALUES ($"user_id"),
    TO VERTEX MLG_Survey VALUES ($"survey_id", $"score")
    USING JSON_FILE="true";

  LOAD f_directors
    TO VERTEX MLG_Director VALUES ($"id")
    USING JSON_FILE="true";

  LOAD f_actors
    TO VERTEX MLG_Actor VALUES ($"id")
    USING JSON_FILE="true";
}

RUN LOADING JOB load_mlgenome_vertices

CREATE LOADING JOB load_mlgenome_edges FOR GRAPH mlgenome {
  DEFINE FILENAME f_ratings   = "/datasets/prop_datasets/movielens/genome_2021/raw/ratings_tigergraph.json";
  DEFINE FILENAME f_tag_count = "/datasets/prop_datasets/movielens/genome_2021/raw/tag_count.json";
  DEFINE FILENAME f_reviews   = "/datasets/prop_datasets/movielens/genome_2021/raw/review_with_id_tigergraph.json";
  DEFINE FILENAME f_surveys   = "/datasets/prop_datasets/movielens/genome_2021/raw/surveys_id.json";
  DEFINE FILENAME f_directed  = "/datasets/prop_datasets/movielens/genome_2021/raw/director_movie_edges_tigergraph.json";
  DEFINE FILENAME f_acted_in  = "/datasets/prop_datasets/movielens/genome_2021/raw/actor_movie_edge_tigergraph.json";

  LOAD f_ratings
    TO EDGE MLG_RATED VALUES (
      $"user_id", $"item_id", $"rating_id", $"rating"
    )
    USING JSON_FILE="true", VERTEX_MUST_EXIST="true";

  LOAD f_tag_count
    TO EDGE MLG_HAS_TAG VALUES ($"item_id", $"tag_id", $"num")
    USING JSON_FILE="true", VERTEX_MUST_EXIST="true";

  LOAD f_reviews
    TO EDGE MLG_HAS_REVIEW VALUES ($"item_id", $"review_id")
    USING JSON_FILE="true", VERTEX_MUST_EXIST="true";

  LOAD f_surveys
    TO EDGE MLG_ANSWERED VALUES ($"user_id", $"survey_id"),
    TO EDGE MLG_ABOUT_MOVIE VALUES ($"survey_id", $"item_id"),
    TO EDGE MLG_ABOUT_TAG VALUES ($"survey_id", $"tag_id")
    USING JSON_FILE="true", VERTEX_MUST_EXIST="true";

  LOAD f_directed
    TO EDGE MLG_DIRECTED VALUES ($"src", $"dst")
    USING JSON_FILE="true", VERTEX_MUST_EXIST="true";

  LOAD f_acted_in
    TO EDGE MLG_ACTED_IN VALUES ($"src", $"dst")
    USING JSON_FILE="true", VERTEX_MUST_EXIST="true";
}

RUN LOADING JOB load_mlgenome_edges
Queries
Select a query below to view its logic and description.
Q1. Movies Rated by a Selected MLG_User
This query lists the movies directly connected to a selected user through outgoing RATED edges.
CREATE OR REPLACE DISTRIBUTED QUERY q1_movies_rated_by_user(UINT p_user_id = 997206)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT m.item_id AS MovieID, m.title AS Movie, r.rating AS Rating INTO result
  FROM (u:MLG_User)-[r:MLG_RATED]->(m:MLG_Movie)
  WHERE u.user_id == p_user_id
  ORDER BY Rating DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (u:mlgenome_user {user_id: 1})-[r:mlgenome_rated]->(m:mlgenome_movie)
RETURN m.item_id AS MovieID, m.title AS Movie, r.rating AS Rating
ORDER BY Rating DESC
LIMIT 20
Q2. Two-Hop Rating Neighborhood of a MLG_User.
This query finds distinct users reachable within two RATED hops from a selected user through shared movies.
// Results are split by HopCount to avoid unsupported path introspection.
CREATE OR REPLACE DISTRIBUTED QUERY q2_two_hop_rating_neighborhood(UINT p_user_id = 997206)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT DISTINCT m.item_id AS NeighborID, m.title AS Neighbor, 1 AS HopCount
    INTO hop1
  FROM (u:MLG_User)-[:MLG_RATED]->(m:MLG_Movie)
  WHERE u.user_id == p_user_id
  ORDER BY Neighbor;

  SELECT DISTINCT other.user_id AS NeighborID, to_string(other.user_id) AS Neighbor,
                  2 AS HopCount INTO hop2
  FROM (u:MLG_User)-[:MLG_RATED]->(m:MLG_Movie)-[:MLG_RATED_BY]->(other:MLG_User)
  WHERE u.user_id == p_user_id AND other.user_id != p_user_id
  ORDER BY Neighbor;
  PRINT hop1, hop2;
}
Equivalent query in GQL standard:
MATCH p = (u:mlgenome_user {user_id: 1})-[:mlgenome_rated]-{1,2}(n)
WHERE n != u
RETURN DISTINCT labels(n) AS NodeLabels,
       coalesce(n.title, toString(n.user_id)) AS Neighbor,
       length(p) AS HopCount
ORDER BY HopCount ASC, Neighbor
LIMIT 50
Q3. Users Exactly Two Hops Away Through Shared Movies
This query returns users exactly two RATED hops away from a selected user, meaning users who rated at least one same movie.
CREATE OR REPLACE DISTRIBUTED QUERY q3_users_two_hops_away(UINT p_user_id = 997206)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT other.user_id AS SimilarUser, COUNT(DISTINCT m) AS SharedMovies INTO result
  FROM (u:MLG_User)-[:MLG_RATED]->(m:MLG_Movie)-[:MLG_RATED_BY]->(other:MLG_User)
  WHERE u.user_id == p_user_id AND other.user_id != p_user_id
  GROUP BY other.user_id
  ORDER BY SharedMovies DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (u:mlgenome_user {user_id: 1})-[:mlgenome_rated]->(m:mlgenome_movie)<-[:mlgenome_rated]-(other:mlgenome_user)
WHERE other != u
RETURN other.user_id AS SimilarUser, count(DISTINCT m) AS SharedMovies
ORDER BY SharedMovies DESC
LIMIT 20
Q4. High-Rated One-Hop MLG_Movie Neighborhood
This query searches a selected user's immediate movie neighborhood while filtering on both the RATED edge value and the movie's average rating.
CREATE OR REPLACE DISTRIBUTED QUERY q4_high_rated_movies(UINT p_user_id = 997206)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT m.item_id AS MovieID, m.title AS Movie, r.rating AS UserRating,
         m.avgRating AS AverageRating INTO result
  FROM (u:MLG_User)-[r:MLG_RATED]->(m:MLG_Movie)
  WHERE u.user_id == p_user_id AND r.rating >= 4.0 AND m.avgRating >= 4.0
  ORDER BY UserRating DESC, AverageRating DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (u:mlgenome_user {user_id: 1})-[r:mlgenome_rated]->(m:mlgenome_movie)
WHERE r.rating >= 4.0 AND m.avgRating >= 4.0
RETURN m.item_id AS MovieID, m.title AS Movie, r.rating AS UserRating, m.avgRating AS AverageRating
ORDER BY UserRating DESC, AverageRating DESC
LIMIT 20
Q5. Users Who Did NOT Participate in Any MLG_Survey
This query identifies users who have not participated in any tag genome surveys.
CREATE OR REPLACE DISTRIBUTED QUERY q5_users_without_surveys()
FOR GRAPH mlgenome SYNTAX V1 {
  SumAccum<INT> @survey_count;
  users = {MLG_User.*};
  participated = SELECT u
                 FROM users:u -(MLG_ANSWERED:e)-> MLG_Survey:s
                 ACCUM u.@survey_count += 1;
  result = SELECT u FROM users:u WHERE u.@survey_count == 0;
  PRINT result[result.user_id AS UserID];
}
Equivalent query in GQL standard:
MATCH (u:mlgenome_user)
WHERE NOT (u)-[:mlgenome_answered]->(:mlgenome_survey)
RETURN u.user_id AS UserID
LIMIT 20
Q6. High-Count MLG_Movie MLG_Tag Edges
This query filters HAS_TAG edges by their count property to find strong movie-tag associations.
CREATE OR REPLACE DISTRIBUTED QUERY q6_high_count_movie_tags(UINT p_min_count = 20)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT m.title AS Movie, t.tag AS Tag, ht.tag_count AS TagCount INTO result
  FROM (m:MLG_Movie)-[ht:MLG_HAS_TAG]->(t:MLG_Tag)
  WHERE ht.tag_count >= p_min_count
  ORDER BY TagCount DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (m:mlgenome_movie)-[ht:mlgenome_has_tag]->(t:mlgenome_tag)
WHERE ht.count >= 20
RETURN m.title AS Movie, t.tag AS Tag, ht.count AS TagCount
ORDER BY TagCount DESC
LIMIT 20
Q7. MLG_User Reachability to a Selected MLG_Tag Through Rated Movies
This query checks whether a selected user can reach a selected tag through movies they rated.
CREATE OR REPLACE DISTRIBUTED QUERY q7_user_reachable_tag(UINT p_user_id = 997206, UINT p_tag_id = 22)
FOR GRAPH mlgenome SYNTAX V1 {
  OrAccum @@reachable;
  users = {MLG_User.*};
  rated_movies = SELECT m
                 FROM users:u -(MLG_RATED:r)-> :m
                 WHERE u.user_id == p_user_id;
  reached = SELECT t
            FROM rated_movies:m -(MLG_HAS_TAG:ht)-> :t
            WHERE t.tag_id == p_tag_id
            ACCUM @@reachable += TRUE;
  PRINT p_user_id AS UserID, p_tag_id AS TagID, @@reachable AS Reachable;
}
Equivalent query in GQL standard:
MATCH (u:mlgenome_user {user_id: 1})
MATCH (t:mlgenome_tag)
WITH u, t
LIMIT 1
OPTIONAL MATCH p = (u)-[:mlgenome_rated]->(:mlgenome_movie)-[:mlgenome_has_tag]->(t)
RETURN u.user_id AS UserID, t.tag AS Tag, count(p) > 0 AS Reachable
Q8. Shortest MLG_User-to-MLG_Tag Explanation Path.
This query finds the shortest path from a user to a tag over ratings and movie-tag relationships.
// A valid path in this bipartite schema has either 2 or 4 hops. The direct
// table is the shortest result when nonempty; otherwise use via_other_user.
CREATE OR REPLACE DISTRIBUTED QUERY q8_shortest_user_tag_path(UINT p_user_id = 997206,
                                                   UINT p_tag_id = 22)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT u.user_id AS UserID, m.title AS Movie, t.tag AS Tag, 2 AS Hops
    INTO direct_path
  FROM (u:MLG_User)-[:MLG_RATED]->(m:MLG_Movie)-[:MLG_HAS_TAG]->(t:MLG_Tag)
  WHERE u.user_id == p_user_id AND t.tag_id == p_tag_id
  LIMIT 1;

  SELECT u.user_id AS UserID, m1.title AS FirstMovie,
         other.user_id AS ViaUser, m2.title AS LastMovie,
         t.tag AS Tag, 4 AS Hops INTO via_other_user
  FROM (u:MLG_User)-[:MLG_RATED]->(m1:MLG_Movie)-[:MLG_RATED_BY]->(other:MLG_User)
       -[:MLG_RATED]->(m2:MLG_Movie)-[:MLG_HAS_TAG]->(t:MLG_Tag)
  WHERE u.user_id == p_user_id AND t.tag_id == p_tag_id
    AND other.user_id != p_user_id AND m1.item_id != m2.item_id
  LIMIT 1;
  PRINT direct_path, via_other_user;
}
Equivalent query in GQL standard:
MATCH p = SHORTEST (u:mlgenome_user {user_id: 1})-[:mlgenome_rated|mlgenome_has_tag]-{1,4}(t:mlgenome_tag)
RETURN p
Q9. Simple Co-Rating Paths Between Two Users (1..3 hops).
This query enumerates simple RATED paths up to four hops between one user and another user in the rating graph.
// Match Cypher's internal `MATCH (target:User) ... LIMIT 1` by choosing one
// non-source user inside this query. MinAccum makes the otherwise arbitrary
// choice deterministic without exposing an extra query parameter.
// In the MLG_User/MLG_Movie bipartite rating graph, a path from one MLG_User
// to another can only have even length, so the 1..3 range yields 2-hop paths.
CREATE OR REPLACE DISTRIBUTED QUERY q9_simple_corating_paths(UINT p_source_user_id = 997206)
FOR GRAPH mlgenome SYNTAX V3 {
  MinAccum<UINT> @@target_user_id;

  scanned_users =
    SELECT t
    FROM (t:MLG_User)
    WHERE t.user_id != p_source_user_id
    ACCUM @@target_user_id += t.user_id;

  SELECT s.user_id AS SourceUser, m.title AS Movie, t.user_id AS TargetUser,
         2 AS Hops INTO paths_2
  FROM (s:MLG_User)-[:MLG_RATED]->(m:MLG_Movie)-[:MLG_RATED_BY]->(t:MLG_User)
  WHERE s.user_id == p_source_user_id AND t.user_id == @@target_user_id;
  PRINT paths_2;
}
Equivalent query in GQL standard:
MATCH p = ACYCLIC (source:mlgenome_user {user_id: 1})-[:mlgenome_rated]-{1,4}(target:mlgenome_user)
WHERE target != source
RETURN p
LIMIT 20
Q10. MLG_User-MLG_Movie Co-Rating Squares
This query finds two users who both rated the same pair of movies, forming a four-node square in the user-movie rating graph.
CREATE OR REPLACE DISTRIBUTED QUERY q10_corating_squares()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT u1.user_id AS User1, u2.user_id AS User2,
         m1.title AS Movie1, m2.title AS Movie2 INTO result
  FROM (u1:MLG_User)-[:MLG_RATED]->(m1:MLG_Movie)-[:MLG_RATED_BY]->(u2:MLG_User)
       -[:MLG_RATED]->(m2:MLG_Movie)-[:MLG_RATED_BY]->(u1)
  WHERE u1.user_id < u2.user_id AND m1.item_id < m2.item_id;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (u1:mlgenome_user)-[:mlgenome_rated]->(m1:mlgenome_movie)<-[:mlgenome_rated]-(u2:mlgenome_user)-[:mlgenome_rated]->(m2:mlgenome_movie)<-[:mlgenome_rated]-(u1)
WHERE u1.user_id < u2.user_id AND m1.item_id < m2.item_id
RETURN u1.user_id AS User1, u2.user_id AS User2, m1.title AS Movie1, m2.title AS Movie2
LIMIT 20
Q11. MLG_Movie Star Pattern Across Cast, Tags, and Reviews
This query treats each movie as a star center connected to actors, tags, and reviews, then returns the busiest centers.
CREATE OR REPLACE DISTRIBUTED QUERY q11_movie_star_pattern()
FOR GRAPH mlgenome SYNTAX V1 {
  SumAccum<INT> @actor_count;
  SumAccum<INT> @tag_count;
  SumAccum<INT> @review_count;
  SumAccum<INT> @star_degree;

  actors = {MLG_Actor.*};
  actor_pass = SELECT m FROM actors:a -(MLG_ACTED_IN:e)-> MLG_Movie:m
               ACCUM m.@actor_count += 1;
  movies = {MLG_Movie.*};
  tag_pass = SELECT m FROM movies:m -(MLG_HAS_TAG:e)-> MLG_Tag:t
             ACCUM m.@tag_count += 1;
  review_pass = SELECT m FROM movies:m -(MLG_HAS_REVIEW:e)-> MLG_Review:r
                ACCUM m.@review_count += 1;
  result = SELECT m FROM movies:m
           POST-ACCUM m.@star_degree = m.@actor_count + m.@tag_count + m.@review_count
           HAVING m.@actor_count >= 2 AND m.@tag_count >= 2
           ORDER BY m.@star_degree DESC;
  PRINT result[result.title AS Movie, result.@actor_count AS ActorCount,
               result.@tag_count AS TagCount, result.@review_count AS ReviewCount,
               result.@star_degree AS StarDegree];
}
Equivalent query in GQL standard:
MATCH (m:mlgenome_movie)
OPTIONAL MATCH (a:mlgenome_actor)-[:mlgenome_acted_in]->(m)
OPTIONAL MATCH (m)-[:mlgenome_has_tag]->(t:mlgenome_tag)
OPTIONAL MATCH (m)-[:mlgenome_has_review]->(r:mlgenome_review)
WITH m, count(DISTINCT a) AS ActorCount, count(DISTINCT t) AS TagCount, count(DISTINCT r) AS ReviewCount
WHERE ActorCount >= 2 AND TagCount >= 2
RETURN m.title AS Movie, ActorCount, TagCount, ReviewCount, ActorCount + TagCount + ReviewCount AS StarDegree
ORDER BY StarDegree DESC
LIMIT 20
Q12. Four-MLG_Actor Co-Starring Cliques
This query finds four actors who co-star in the same movie, representing a four-clique in the projected co-actor graph.
CREATE OR REPLACE DISTRIBUTED QUERY q12_four_actor_costarring_cliques()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT m.title AS Movie, a1.name AS Actor1, a2.name AS Actor2,
         a3.name AS Actor3, a4.name AS Actor4 INTO result
  FROM (a1:MLG_Actor)-[:MLG_ACTED_IN]->(m:MLG_Movie),
       (a2:MLG_Actor)-[:MLG_ACTED_IN]->(m),
       (a3:MLG_Actor)-[:MLG_ACTED_IN]->(m),
       (a4:MLG_Actor)-[:MLG_ACTED_IN]->(m)
  WHERE a1.name < a2.name AND a2.name < a3.name AND a3.name < a4.name;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (a1:mlgenome_actor)-[:mlgenome_acted_in]->(m:mlgenome_movie)<-[:mlgenome_acted_in]-(a2:mlgenome_actor),
      (a3:mlgenome_actor)-[:mlgenome_acted_in]->(m)<-[:mlgenome_acted_in]-(a4:mlgenome_actor)
WHERE a1.name < a2.name AND a2.name < a3.name AND a3.name < a4.name
RETURN m.title AS Movie, a1.name AS Actor1, a2.name AS Actor2, a3.name AS Actor3, a4.name AS Actor4
LIMIT 20
Q13. Most Similar Users Based on Ratings for the Same Movies
This query finds pairs of users who have rated the same movies similarly (within a difference of 1 rating point) and share at least 5 such movie preferences.
CREATE OR REPLACE DISTRIBUTED QUERY q13_similar_users_by_ratings(UINT p_min_shared = 5)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT u1.user_id AS User1, u2.user_id AS User2,
         COUNT(m) AS SharedMovies INTO result
  FROM (u1:MLG_User)-[r1:MLG_RATED]->(m:MLG_Movie)-[r2:MLG_RATED_BY]->(u2:MLG_User)
  WHERE u1.user_id != u2.user_id AND abs(r1.rating - r2.rating) <= 1
  GROUP BY u1.user_id, u2.user_id
  HAVING SharedMovies >= p_min_shared
  ORDER BY SharedMovies DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (u1:mlgenome_user)-[r1:mlgenome_rated]->(m:mlgenome_movie)<-[r2:mlgenome_rated]-(u2:mlgenome_user)
WHERE u1 != u2 AND abs(r1.rating - r2.rating) <= 1
WITH u1.user_id AS User1, u2.user_id AS User2, count(m) AS SharedMovies
WHERE SharedMovies >= 5
RETURN User1, User2, SharedMovies
ORDER BY SharedMovies DESC
LIMIT 10
Q14. MLG_User-MLG_Survey-MLG_Movie-MLG_Tag Line Pattern
This query follows a four-node line from users to surveys, then to movies, and finally to tags attached to those movies.
CREATE OR REPLACE DISTRIBUTED QUERY q14_user_survey_movie_tag()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT u.user_id AS UserID, s.survey_id AS SurveyID, m.title AS Movie,
         t.tag AS Tag, s.score AS SurveyScore INTO result
  FROM (u:MLG_User)-[:MLG_ANSWERED]->(s:MLG_Survey)-[:MLG_ABOUT_MOVIE]->(m:MLG_Movie)
       -[:MLG_HAS_TAG]->(t:MLG_Tag);
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (u:mlgenome_user)-[:mlgenome_answered]->(s:mlgenome_survey)-[:mlgenome_about_movie]->(m:mlgenome_movie)-[:mlgenome_has_tag]->(t:mlgenome_tag)
RETURN u.user_id AS UserID, s.survey_id AS SurveyID, m.title AS Movie, t.tag AS Tag, s.score AS SurveyScore
LIMIT 20
Q15. MLG_Movie Degree Summary Across All Relationship Types
This query computes ungrouped degree statistics for Movie nodes across their adjacent relationships.
CREATE OR REPLACE DISTRIBUTED QUERY q15_movie_degree_summary()
FOR GRAPH mlgenome SYNTAX V1 {
  SumAccum<INT> @degree;
  SumAccum<INT> @@movie_count;
  SumAccum<INT> @@degree_sum;
  MinAccum<INT> @@min_degree;
  MaxAccum<INT> @@max_degree;
  DOUBLE avg_degree = 0.0;
  movies = {MLG_Movie.*};
  users = {MLG_User.*};
  surveys = {MLG_Survey.*};
  directors = {MLG_Director.*};
  actors = {MLG_Actor.*};

  p1 = SELECT m FROM users:u -(MLG_RATED:e)-> :m ACCUM m.@degree += 1;
  p2 = SELECT t FROM movies:m -(MLG_HAS_TAG:e)-> :t ACCUM m.@degree += 1;
  p3 = SELECT r FROM movies:m -(MLG_HAS_REVIEW:e)-> :r ACCUM m.@degree += 1;
  p4 = SELECT m FROM surveys:s -(MLG_ABOUT_MOVIE:e)-> :m ACCUM m.@degree += 1;
  p5 = SELECT m FROM directors:d -(MLG_DIRECTED:e)-> :m ACCUM m.@degree += 1;
  p6 = SELECT m FROM actors:a -(MLG_ACTED_IN:e)-> :m ACCUM m.@degree += 1;

  summary = SELECT m FROM movies:m
            POST-ACCUM @@movie_count += 1,
                       @@degree_sum += m.@degree,
                       @@min_degree += m.@degree,
                       @@max_degree += m.@degree;
  IF @@movie_count > 0 THEN
    avg_degree = 1.0 * @@degree_sum / @@movie_count;
  END;
  PRINT @@movie_count AS MovieCount, avg_degree AS AvgDegree,
        @@min_degree AS MinDegree, @@max_degree AS MaxDegree;
}
Equivalent query in GQL standard:
MATCH (m:mlgenome_movie)
OPTIONAL MATCH (m)-[]-(n)
WITH m, count(DISTINCT n) AS Degree
RETURN count(m) AS MovieCount,
       round(avg(Degree), 2) AS AvgDegree,
       min(Degree) AS MinDegree,
       max(Degree) AS MaxDegree
Q16. Directors by Average MLG_Movie Rating
This query computes the average rating and movie count for each director with at least 3 movies, sorting them to find the top 10 highest-rated directors.
CREATE OR REPLACE DISTRIBUTED QUERY q16_directors_by_average_rating(UINT p_min_movies = 3)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT d.name AS Director, AVG(m.avgRating) AS AvgRating,
         COUNT(m) AS Movies INTO result
  FROM (d:MLG_Director)-[:MLG_DIRECTED]->(m:MLG_Movie)
  GROUP BY d.name
  HAVING Movies >= p_min_movies
  ORDER BY AvgRating DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (d:mlgenome_director)-[:mlgenome_directed]->(m:mlgenome_movie)
WHERE m.avgRating IS NOT NULL
WITH d.name AS Director, avg(m.avgRating) AS AvgRating, count(m) AS Movies
WHERE Movies >= 3
RETURN Director, round(AvgRating, 2) AS AvgRating, Movies
ORDER BY AvgRating DESC
LIMIT 10
Q17. Actors by Number of Movies Acted In
This query calculates the total number of movies each actor has starred in and returns the top 10 most prolific actors.
CREATE OR REPLACE DISTRIBUTED QUERY q17_actors_by_movie_count()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT a.name AS Actor, COUNT(m) AS TotalMovies INTO result
  FROM (a:MLG_Actor)-[:MLG_ACTED_IN]->(m:MLG_Movie)
  GROUP BY a.name
  ORDER BY TotalMovies DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (a:mlgenome_actor)-[:mlgenome_acted_in]->(m:mlgenome_movie)
RETURN a.name AS Actor, count(m) AS TotalMovies
ORDER BY TotalMovies DESC
LIMIT 10
Q18. Rating Edge Summary
This query summarizes all RATED edges by count and rating-value statistics.
CREATE OR REPLACE DISTRIBUTED QUERY q18_rating_edge_summary()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT COUNT(r) AS RatingCount, AVG(r.rating) AS AvgRating,
         MIN(r.rating) AS MinRating, MAX(r.rating) AS MaxRating INTO result
  FROM (:MLG_User)-[r:MLG_RATED]->(:MLG_Movie);
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (:mlgenome_user)-[r:mlgenome_rated]->(:mlgenome_movie)
RETURN count(r) AS RatingCount,
       round(avg(r.rating), 2) AS AvgRating,
       min(r.rating) AS MinRating,
       max(r.rating) AS MaxRating
Q19. Users Who Rate Harshly
This query identifies the top 10 users with the lowest average ratings among those who have submitted at least 5 ratings, highlighting the harshest critics.
CREATE OR REPLACE DISTRIBUTED QUERY q19_harsh_raters(UINT p_min_ratings = 5)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT u.user_id AS UserID, AVG(r.rating) AS AvgRating,
         COUNT(r) AS TotalRatings INTO result
  FROM (u:MLG_User)-[r:MLG_RATED]->(:MLG_Movie)
  GROUP BY u.user_id
  HAVING TotalRatings >= p_min_ratings
  ORDER BY AvgRating ASC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (u:mlgenome_user)-[r:mlgenome_rated]->(m:mlgenome_movie)
WHERE r.rating IS NOT NULL
WITH u.user_id AS UserID, count(r) AS TotalRatings, avg(r.rating) AS AvgRating
WHERE TotalRatings >= 5
RETURN UserID, round(AvgRating, 2) AS AvgRating, TotalRatings
ORDER BY AvgRating ASC
LIMIT 10
Q20. Bounded Rating Path Counts by Length.
This query counts bounded RATED paths from a selected user and groups the result only by path length.
// The three result tables correspond exactly to PathLength 1, 2, and 3.
CREATE OR REPLACE DISTRIBUTED QUERY q20_bounded_rating_path_counts(UINT p_user_id = 997206)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT 1 AS PathLength, COUNT(*) AS PathCount,
         COUNT(DISTINCT m) AS DistinctTargets INTO length_1
  FROM (u:MLG_User)-[:MLG_RATED]->(m:MLG_Movie)
  WHERE u.user_id == p_user_id;

  SELECT 2 AS PathLength, COUNT(*) AS PathCount,
         COUNT(DISTINCT other) AS DistinctTargets INTO length_2
  FROM (u:MLG_User)-[:MLG_RATED]->(:MLG_Movie)-[:MLG_RATED_BY]->(other:MLG_User)
  WHERE u.user_id == p_user_id;

  SELECT 3 AS PathLength, COUNT(*) AS PathCount,
         COUNT(DISTINCT m) AS DistinctTargets INTO length_3
  FROM (u:MLG_User)-[:MLG_RATED]->(:MLG_Movie)-[:MLG_RATED_BY]->(:MLG_User)
       -[:MLG_RATED]->(m:MLG_Movie)
  WHERE u.user_id == p_user_id;
  PRINT length_1, length_2, length_3;
}
Equivalent query in GQL standard:
MATCH p = (:mlgenome_user {user_id: 1})-[:mlgenome_rated]-{1,3}(target)
RETURN length(p) AS PathLength,
       count(p) AS PathCount,
       count(DISTINCT target) AS DistinctTargets
ORDER BY PathLength ASC
Q21. Bounded Rating Path Counts by Length and Endpoint Type
This query extends path-count aggregation by grouping bounded paths by both path length and endpoint label.
CREATE OR REPLACE DISTRIBUTED QUERY q21_path_counts_by_endpoint_type(UINT p_user_id = 997206)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT 1 AS PathLength, "MLG_Movie" AS EndpointType, COUNT(*) AS PathCount,
         COUNT(DISTINCT m) AS DistinctTargets INTO length_1_movie
  FROM (u:MLG_User)-[:MLG_RATED]->(m:MLG_Movie)
  WHERE u.user_id == p_user_id;

  SELECT 2 AS PathLength, "MLG_User" AS EndpointType, COUNT(*) AS PathCount,
         COUNT(DISTINCT other) AS DistinctTargets INTO length_2_user
  FROM (u:MLG_User)-[:MLG_RATED]->(:MLG_Movie)-[:MLG_RATED_BY]->(other:MLG_User)
  WHERE u.user_id == p_user_id;

  SELECT 3 AS PathLength, "MLG_Movie" AS EndpointType, COUNT(*) AS PathCount,
         COUNT(DISTINCT m) AS DistinctTargets INTO length_3_movie
  FROM (u:MLG_User)-[:MLG_RATED]->(:MLG_Movie)-[:MLG_RATED_BY]->(:MLG_User)-[:MLG_RATED]->(m:MLG_Movie)
  WHERE u.user_id == p_user_id;
  PRINT length_1_movie, length_2_user, length_3_movie;
}
Equivalent query in GQL standard:
MATCH p = (:mlgenome_user {user_id: 1})-[:mlgenome_rated]-{1,3}(target)
WITH length(p) AS PathLength, labels(target)[0] AS EndpointType, target, p
RETURN PathLength,
       EndpointType,
       count(p) AS PathCount,
       count(DISTINCT target) AS DistinctTargets
ORDER BY PathLength ASC, PathCount DESC
Q22. Directors with the Most Movies Above 4.0 Rating
This query finds the top 10 directors with the most movies rated 4.0 or above, considering only directors who have at least 2 such highly-rated movies.
CREATE OR REPLACE DISTRIBUTED QUERY q22_directors_with_high_rated_movies(
  FLOAT p_min_rating = 4.0, UINT p_min_movies = 2
) FOR GRAPH mlgenome SYNTAX V3 {
  SELECT d.name AS Director, COUNT(m) AS HighRatedMovies INTO result
  FROM (d:MLG_Director)-[:MLG_DIRECTED]->(m:MLG_Movie)
  WHERE m.avgRating >= p_min_rating
  GROUP BY d.name
  HAVING HighRatedMovies >= p_min_movies
  ORDER BY HighRatedMovies DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (d:mlgenome_director)-[:mlgenome_directed]->(m:mlgenome_movie)
WHERE m.avgRating >= 4.0
WITH d.name AS Director, count(m) AS HighRatedMovies
WHERE HighRatedMovies >= 2
RETURN Director, HighRatedMovies
ORDER BY HighRatedMovies DESC
LIMIT 10
Q23. Top Tags by Frequency in Surveys
This query counts the total number of survey evaluations for each tag and returns the top 10 most frequently evaluated tags.
CREATE OR REPLACE DISTRIBUTED QUERY q23_tags_by_survey_frequency()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT t.tag AS Tag, COUNT(*) AS SurveyCount INTO result
  FROM (:MLG_Survey)-[:MLG_ABOUT_TAG]->(t:MLG_Tag)
  GROUP BY t.tag
  ORDER BY SurveyCount DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (:mlgenome_survey)-[:mlgenome_about_tag]->(t:mlgenome_tag)
RETURN t.tag AS Tag, count(*) AS SurveyCount
ORDER BY SurveyCount DESC
LIMIT 10
Q24. Tags Most Frequently Scored Highly in Surveys
This query identifies tags that users consistently score highly (survey score >= 4) and returns the top 10 highest-scoring tags.
CREATE OR REPLACE DISTRIBUTED QUERY q24_high_scored_survey_tags(UINT p_min_score = 4)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT t.tag AS Tag, COUNT(*) AS HighScoreCount INTO result
  FROM (s:MLG_Survey)-[:MLG_ABOUT_TAG]->(t:MLG_Tag)
  WHERE s.score >= p_min_score
  GROUP BY t.tag
  ORDER BY HighScoreCount DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (s:mlgenome_survey)-[:mlgenome_about_tag]->(t:mlgenome_tag)
WHERE s.score >= 4
RETURN t.tag AS Tag, count(*) AS HighScoreCount
ORDER BY HighScoreCount DESC
LIMIT 10
Q25. Movies With Most Tagged MLG_Survey Feedback
This query finds the top 10 movies that have been evaluated the most number of times in tag genome surveys.
CREATE OR REPLACE DISTRIBUTED QUERY q25_movies_with_most_survey_feedback()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT m.title AS Movie, COUNT(*) AS SurveyMentions INTO result
  FROM (:MLG_Survey)-[:MLG_ABOUT_MOVIE]->(m:MLG_Movie)
  GROUP BY m.title
  ORDER BY SurveyMentions DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (s:mlgenome_survey)-[:mlgenome_about_movie]->(m:mlgenome_movie)
RETURN m.title AS Movie, count(*) AS SurveyMentions
ORDER BY SurveyMentions DESC
LIMIT 10
Q26. Users Who Participated in the Most Surveys
This query lists the top 10 users who have participated in the highest number of tag genome surveys.
CREATE OR REPLACE DISTRIBUTED QUERY q26_users_with_most_surveys()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT u.user_id AS User, COUNT(s) AS TotalSurveys INTO result
  FROM (u:MLG_User)-[:MLG_ANSWERED]->(s:MLG_Survey)
  GROUP BY u.user_id
  ORDER BY TotalSurveys DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (u:mlgenome_user)-[:mlgenome_answered]->(s:mlgenome_survey)
RETURN u.user_id AS User, count(s) AS TotalSurveys
ORDER BY TotalSurveys DESC
LIMIT 10
Q27. PageRank on the undirected MLG_User-MLG_Movie rating graph.
This query runs PageRank over an undirected User-Movie rating graph projection and returns the highest-scoring nodes.
// MLG_RATED and its stored reverse MLG_RATED_BY together form the undirected projection.
CREATE OR REPLACE DISTRIBUTED QUERY q27_rating_graph_pagerank(
  INT p_max_iterations = 25, DOUBLE p_damping = 0.85, INT p_top_k = 400000
) FOR GRAPH mlgenome SYNTAX V1 {
  TYPEDEF TUPLE <label STRING, node STRING, score DOUBLE> PRRow;
  SumAccum<DOUBLE> @rank;
  SumAccum<DOUBLE> @next_rank;
  SumAccum<INT> @degree;
  HeapAccum<PRRow>(p_top_k, score DESC) @@top;
  INT i = 0;

  users = {MLG_User.*};
  movie_vertices = {MLG_Movie.*};
  all_vertices = users UNION movie_vertices;
  degree_pass = SELECT t
                FROM all_vertices:s -((MLG_RATED|MLG_RATED_BY):e)-> :t
                ACCUM s.@degree += 1;
  initialized = SELECT v FROM all_vertices:v POST-ACCUM v.@rank = 1.0;

  WHILE i < p_max_iterations DO
    propagated = SELECT t
                 FROM all_vertices:s -((MLG_RATED|MLG_RATED_BY):e)-> :t
                 WHERE s.@degree > 0
                 ACCUM t.@next_rank += s.@rank / s.@degree;
    updated = SELECT v FROM all_vertices:v
              POST-ACCUM v.@rank = (1.0 - p_damping) + p_damping * v.@next_rank,
                         v.@next_rank = 0.0;
    i = i + 1;
  END;

  user_rows = SELECT u FROM users:u
              POST-ACCUM @@top += PRRow("MLG_User", to_string(u.user_id), u.@rank);
  movie_rows = SELECT m FROM movie_vertices:m
               POST-ACCUM @@top += PRRow("MLG_Movie", m.title, m.@rank);
  PRINT @@top AS PageRank;
}
Q28. Weakly Connected Components of the undirected rating graph.
This query finds weakly connected components in the undirected User-Movie rating graph projection.
// Component labels are encoded as user_id*2 and item_id*2+1 so the two vertex
// namespaces cannot collide. Output is a component_id -> size map.
CREATE OR REPLACE DISTRIBUTED QUERY q28_rating_graph_wcc(INT p_max_iterations = 100)
FOR GRAPH mlgenome SYNTAX V1 {
  MinAccum<INT> @component;
  MinAccum<INT> @candidate;
  OrAccum @@changed;
  MapAccum<INT, SumAccum<INT>> @@component_sizes;
  INT i = 0;

  users = {MLG_User.*};
  movie_vertices = {MLG_Movie.*};
  all_vertices = users UNION movie_vertices;
  init_users = SELECT u FROM users:u
               POST-ACCUM u.@component = str_to_int(to_string(u.user_id)) * 2;
  init_movies = SELECT m FROM movie_vertices:m
                POST-ACCUM m.@component = str_to_int(to_string(m.item_id)) * 2 + 1;

  @@changed = TRUE;
  WHILE @@changed AND i < p_max_iterations DO
    @@changed = FALSE;
    propagated = SELECT t
                 FROM all_vertices:s -((MLG_RATED|MLG_RATED_BY):e)-> :t
                 ACCUM t.@candidate += s.@component
                 POST-ACCUM
                   IF t.@candidate < t.@component THEN
                     t.@component = t.@candidate,
                     @@changed += TRUE
                   END;
    i = i + 1;
  END;

  counted = SELECT v FROM all_vertices:v
            POST-ACCUM @@component_sizes += (v.@component -> 1);
  PRINT @@component_sizes AS ComponentSizes;
}
Q29. Strongly Connected Components of Directed Rating Edges
This query treats RATED edges as directed from users to movies and reports strongly connected component sizes.
Q30. Louvain Communities in the Rating Graph.
This query detects communities in the undirected User-Movie rating graph using Louvain and returns the largest communities.
// Self-contained distributed adaptation of TigerGraph's Apache-2.0-licensed
// tg_louvain algorithm. Each logical rating is unweighted; MLG_RATED and MLG_RATED_BY
// together form the symmetric projection used by the Neo4j query.
// Source: https://github.com/tigergraph/gsql-graph-algorithms/blob/tg_4.4.0_dev/algorithms/Community/louvain/tg_louvain.gsql
CREATE OR REPLACE DISTRIBUTED QUERY q30_rating_graph_louvain(
  INT p_max_iterations = 10, INT p_top_k = 400000
) FOR GRAPH mlgenome SYNTAX V1 {
  TYPEDEF TUPLE <FLOAT delta_q, FLOAT community_weight, VERTEX center> Move;
  TYPEDEF TUPLE <VERTEX center, INT community_size> CommunityRow;

  SumAccum<FLOAT> @community_degree_sum;
  ListAccum<VERTEX> @community_center;
  SumAccum<FLOAT> @weighted_degree;
  SumAccum<FLOAT> @center_weight;
  MapAccum<VERTEX, SumAccum<FLOAT>> @weight_by_neighbor_community;
  MaxAccum<Move> @best_move;
  ListAccum<VERTEX> @community_members;
  SumAccum<INT> @degree;

  SumAccum<FLOAT> @@total_edge_weight;
  SumAccum<INT> @@changed;
  MapAccum<VERTEX, SumAccum<INT>> @@community_sizes;
  HeapAccum<CommunityRow>(p_top_k, community_size DESC) @@ordered_sizes;

  users = {MLG_User.*};
  movies = {MLG_Movie.*};
  vertices = users UNION movies;

  // Initialize degree, total graph weight, and singleton communities.
  initialized = SELECT s
                FROM vertices:s -((MLG_RATED|MLG_RATED_BY):e)-> :t
                ACCUM @@total_edge_weight += 0.5,
                      s.@weighted_degree += 1.0,
                      s.@center_weight += 1.0,
                      s.@degree += 1
                POST-ACCUM
                  IF s.@degree > 1 THEN
                    s.@community_center += s
                  END;

  // Special first local-moving iteration from singleton communities.
  first_move = SELECT t
               FROM vertices:s -((MLG_RATED|MLG_RATED_BY):e)-> :t
               WHERE s.@degree > 1 AND t.@degree > 1
               ACCUM
                 t.@best_move += Move(
                   1.0 + @@total_edge_weight * t.@weighted_degree *
                         (t.@weighted_degree - s.@weighted_degree),
                   -s.@center_weight,
                   s.@community_center.get(0)
                 )
               POST-ACCUM
                 IF t.@best_move.delta_q > 0 THEN
                   IF -t.@best_move.community_weight < t.@center_weight THEN
                     t.@community_center.clear(),
                     t.@community_center += t.@best_move.center,
                     t.@center_weight = -t.@best_move.community_weight,
                     @@changed += 1
                   ELSE IF -t.@best_move.community_weight == t.@center_weight
                           AND getvid(t) < getvid(t.@best_move.center) THEN
                     t.@community_center.clear(),
                     t.@community_center += t.@best_move.center,
                     t.@center_weight = -t.@best_move.community_weight,
                     @@changed += 1
                   END
                 END;

  // Parallel Louvain local-moving phase. All state is query-local.
  WHILE @@changed > 0 LIMIT p_max_iterations DO
    @@changed = 0;

    reset_iteration = SELECT s FROM vertices:s
                      WHERE s.@degree > 1
                      POST-ACCUM s.@community_degree_sum = 0,
                                 s.@community_members.clear(),
                                 s.@weight_by_neighbor_community.clear();

    build_member_lists = SELECT s FROM vertices:s
                         ACCUM
                           FOREACH center IN s.@community_center DO
                             IF getvid(center) != -1 THEN
                               center.@community_members += s
                             END
                           END;

    collect_neighbor_communities = SELECT s
      FROM vertices:s -((MLG_RATED|MLG_RATED_BY):e)-> :t
      WHERE t.@degree > 1
      ACCUM s.@weight_by_neighbor_community +=
              (t.@community_center.get(0) -> 1.0);

    sum_community_degrees = SELECT s FROM vertices:s
      ACCUM
        FOREACH center IN s.@community_center DO
          IF getvid(center) != -1 THEN
            center.@community_degree_sum += s.@weighted_degree
          END
        END;

    copy_community_degrees = SELECT s FROM vertices:s
      ACCUM
        FOREACH member IN s.@community_members DO
          IF getvid(member) != -1 THEN
            member.@community_degree_sum = s.@community_degree_sum
          END
        END;

    choose_best_move = SELECT s
      FROM vertices:s -((MLG_RATED|MLG_RATED_BY):e)-> :t
      WHERE t.@degree > 1
      ACCUM
        FLOAT internal_weight = 0.0,
        IF s.@weight_by_neighbor_community.containsKey(s) THEN
          internal_weight = s.@weight_by_neighbor_community.get(s)
        END,
        s.@best_move += Move(
          s.@weight_by_neighbor_community.get(t.@community_center.get(0))
            - internal_weight
            + (1.0 / @@total_edge_weight) * s.@weighted_degree
              * (s.@community_degree_sum - t.@community_degree_sum),
          -t.@center_weight,
          t.@community_center.get(0)
        )
      POST-ACCUM
        IF s.@best_move.delta_q > 0 THEN
          IF -s.@best_move.community_weight < s.@center_weight THEN
            s.@community_center.clear(),
            s.@community_center += s.@best_move.center,
            s.@center_weight = -s.@best_move.community_weight,
            @@changed += 1
          ELSE IF -s.@best_move.community_weight == s.@center_weight
                  AND getvid(s.@community_center.get(0)) < getvid(s.@best_move.center) THEN
            s.@community_center.clear(),
            s.@community_center += s.@best_move.center,
            s.@center_weight = -s.@best_move.community_weight,
            @@changed += 1
          END
        END;
  END;

  // Degree-one vertices follow their neighbor; isolated vertices form a
  // singleton community. These passes make every vertex receive a center.
  degree_one_follow = SELECT s
    FROM vertices:s -((MLG_RATED|MLG_RATED_BY):e)-> :t
    WHERE s.@degree == 1 AND t.@degree != 1
    ACCUM s.@community_center += t.@community_center.get(0);

  degree_one_pairs = SELECT s
    FROM vertices:s -((MLG_RATED|MLG_RATED_BY):e)-> :t
    WHERE s.@degree == 1 AND t.@degree == 1
    ACCUM
      IF getvid(s) <= getvid(t) THEN
        s.@community_center += s
      ELSE
        s.@community_center += t
      END;

  isolated = SELECT s FROM vertices:s
             WHERE s.@degree == 0
             ACCUM s.@community_center += s;

  counted = SELECT s FROM vertices:s
            WHERE s.@community_center.size() > 0
            POST-ACCUM @@community_sizes += (s.@community_center.get(0) -> 1);

  FOREACH (center, community_size) IN @@community_sizes DO
    @@ordered_sizes += CommunityRow(center, community_size);
  END;
  PRINT @@ordered_sizes AS Communities;
}
Q31. Best Tags per MLG_Movie by MLG_Survey and MLG_Tag Count
This query correlates tags applied to movies via direct tag counts with survey evaluations to find movie-tag pairings with the highest average consensus score.
CREATE OR REPLACE DISTRIBUTED QUERY q31_best_tags_per_movie(
  UINT p_min_applications = 5, UINT p_min_mentions = 5
) FOR GRAPH mlgenome SYNTAX V3 {
  SELECT m.title AS Movie, t.tag AS Tag,
         SUM(ht.tag_count) AS TagApplications,
         AVG(s.score) AS AvgSurveyScore,
         COUNT(s) AS SurveyMentions INTO result
  FROM (m:MLG_Movie)-[ht:MLG_HAS_TAG]->(t:MLG_Tag),
       (s:MLG_Survey)-[:MLG_ABOUT_MOVIE]->(m),
       (s)-[:MLG_ABOUT_TAG]->(t)
  GROUP BY m.title, t.tag
  HAVING TagApplications > p_min_applications AND SurveyMentions >= p_min_mentions
  ORDER BY AvgSurveyScore DESC, SurveyMentions DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (m:mlgenome_movie)-[ht:mlgenome_has_tag]->(t:mlgenome_tag)
MATCH (s:mlgenome_survey)-[:mlgenome_about_movie]->(m)
MATCH (s)-[:mlgenome_about_tag]->(t)
WITH m.title AS Movie, t.tag AS Tag,
    sum(ht.count) AS TagApplications,
    avg(s.score) AS AvgSurveyScore,
    count(s) AS SurveyMentions
WHERE TagApplications > 5 AND SurveyMentions >= 5
RETURN Movie, Tag, TagApplications, round(AvgSurveyScore, 2) AS AvgSurveyScore, SurveyMentions
ORDER BY AvgSurveyScore DESC, SurveyMentions DESC
LIMIT 20
Q32. Top MLG_Actor-MLG_Director Pairs by Number of Collaborations
This query finds the top 10 actor-director pairs with the highest number of movie collaborations.
CREATE OR REPLACE DISTRIBUTED QUERY q32_actor_director_collaborations()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT d.name AS Director, a.name AS Actor,
         COUNT(m) AS Collaborations INTO result
  FROM (d:MLG_Director)-[:MLG_DIRECTED]->(m:MLG_Movie),
       (a:MLG_Actor)-[:MLG_ACTED_IN]->(m)
  GROUP BY d.name, a.name
  ORDER BY Collaborations DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (d:mlgenome_director)-[:mlgenome_directed]->(m:mlgenome_movie)<-[:mlgenome_acted_in]-(a:mlgenome_actor)
RETURN d.name AS Director, a.name AS Actor, count(m) AS Collaborations
ORDER BY Collaborations DESC
LIMIT 10
Q33. Directors Whose Movies Collect the Most Reviews
This query finds the top 10 directors whose movies have collectively accumulated the highest number of text reviews.
CREATE OR REPLACE DISTRIBUTED QUERY q33_directors_with_most_reviews()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT d.name AS Director, COUNT(r) AS TotalReviews INTO result
  FROM (d:MLG_Director)-[:MLG_DIRECTED]->(m:MLG_Movie)-[:MLG_HAS_REVIEW]->(r:MLG_Review)
  GROUP BY d.name
  ORDER BY TotalReviews DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (d:mlgenome_director)-[:mlgenome_directed]->(m:mlgenome_movie)-[:mlgenome_has_review]->(r:mlgenome_review)
RETURN d.name AS Director, count(r) AS TotalReviews
ORDER BY TotalReviews DESC
LIMIT 10
Q34. MLG_Actor-MLG_Director Collaboration Quality
This query evaluates the quality of actor-director collaborations by computing the average rating of their shared movies, returning the top 10 pairs with at least 3 collaborations.
CREATE OR REPLACE DISTRIBUTED QUERY q34_actor_director_quality(UINT p_min_collabs = 3)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT d.name AS Director, a.name AS Actor, COUNT(m) AS Collabs,
         AVG(m.avgRating) AS AvgRating INTO result
  FROM (d:MLG_Director)-[:MLG_DIRECTED]->(m:MLG_Movie),
       (a:MLG_Actor)-[:MLG_ACTED_IN]->(m)
  GROUP BY d.name, a.name
  HAVING Collabs >= p_min_collabs
  ORDER BY AvgRating DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (d:mlgenome_director)-[:mlgenome_directed]->(m:mlgenome_movie)<-[:mlgenome_acted_in]-(a:mlgenome_actor)
WHERE m.avgRating IS NOT NULL
WITH d.name AS Director, a.name AS Actor, count(m) AS Collabs, avg(m.avgRating) AS AvgRating
WHERE Collabs >= 3
RETURN Director, Actor, Collabs, round(AvgRating, 2) AS AvgRating
ORDER BY AvgRating DESC
LIMIT 10
Q35. MLG_Tag-MLG_Movie Associations with High Confidence
This query finds movie-tag pairs that are strongly agreed upon by users, based on the frequency of high survey scores (score >= 4).
CREATE OR REPLACE DISTRIBUTED QUERY q35_high_confidence_movie_tags(UINT p_min_score = 4)
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT m.title AS Movie, t.tag AS Tag,
         COUNT(*) AS HighScoreCount INTO result
  FROM (s:MLG_Survey)-[:MLG_ABOUT_MOVIE]->(m:MLG_Movie),
       (s)-[:MLG_ABOUT_TAG]->(t:MLG_Tag)
  WHERE s.score >= p_min_score
  GROUP BY m.title, t.tag
  ORDER BY HighScoreCount DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (s:mlgenome_survey)-[:mlgenome_about_movie]->(m:mlgenome_movie), (s)-[:mlgenome_about_tag]->(t:mlgenome_tag)
WHERE s.score >= 4
RETURN m.title AS Movie, t.tag AS Tag, count(*) AS HighScoreCount
ORDER BY HighScoreCount DESC
LIMIT 10
Q36. Actors in High-Rated Movies with Different Directors
This query finds actors who frequently appear in highly-rated movies (rating >= 4.0) with different directors, showcasing versatile and collaborative actors.
CREATE OR REPLACE DISTRIBUTED QUERY q36_high_rated_actors_different_directors(
  FLOAT p_min_rating = 4.0, UINT p_min_movies = 3
) FOR GRAPH mlgenome SYNTAX V3 {
  SELECT a.name AS Actor, COUNT(DISTINCT d.name) AS UniqueTopDirectors,
         COUNT(DISTINCT m) AS TopRatedMovies INTO result
  FROM (a:MLG_Actor)-[:MLG_ACTED_IN]->(m:MLG_Movie),
       (d:MLG_Director)-[:MLG_DIRECTED]->(m)
  WHERE m.avgRating >= p_min_rating
  GROUP BY a.name
  HAVING TopRatedMovies >= p_min_movies
  ORDER BY UniqueTopDirectors DESC, TopRatedMovies DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (a:mlgenome_actor)-[:mlgenome_acted_in]->(m:mlgenome_movie)<-[:mlgenome_directed]-(d:mlgenome_director)
WHERE m.avgRating >= 4.0
WITH a.name AS Actor, count(DISTINCT d.name) AS UniqueTopDirectors, count(DISTINCT m) AS TopRatedMovies
WHERE TopRatedMovies >= 3
RETURN Actor, UniqueTopDirectors, TopRatedMovies
ORDER BY UniqueTopDirectors DESC, TopRatedMovies DESC
LIMIT 10
Q37. Most Frequently Used Words in Reviews.
This query tokenizes text reviews to extract the most frequently used words, filtering out common stop words.
// Native GSQL split() is delimiter-based, not regex-based. This normalizes the
// most common punctuation and then splits on spaces. It is the closest native
// equivalent to APOC's regex tokenizer without installing a custom C++ UDF.
// The fixed-size heap implements Cypher's ORDER BY freq DESC LIMIT 20.
CREATE OR REPLACE DISTRIBUTED QUERY q37_frequent_review_words()
FOR GRAPH mlgenome SYNTAX V2 {
  TYPEDEF TUPLE <word STRING, freq INT> WordRow;
  MapAccum<STRING, SumAccum<INT>> @@frequencies;
  HeapAccum<WordRow>(20, freq DESC, word ASC) @@top;
  reviews = {MLG_Review.*};

  scanned = SELECT r FROM reviews:r
            ACCUM
              STRING normalized = lower(r.text),
              normalized = replace(normalized, ".", " "),
              normalized = replace(normalized, ",", " "),
              normalized = replace(normalized, ";", " "),
              normalized = replace(normalized, ":", " "),
              normalized = replace(normalized, "!", " "),
              normalized = replace(normalized, "?", " "),
              normalized = replace(normalized, "\"", " "),
              normalized = replace(normalized, "'", " "),
              normalized = replace(normalized, "(", " "),
              normalized = replace(normalized, ")", " "),
              normalized = replace(normalized, "-", " "),
              FOREACH word IN split(normalized, " ") DO
                IF length(word) > 3
                   AND word NOT IN ("this", "that", "with", "from", "have", "your",
                                    "just", "what", "when", "they", "were", "then",
                                    "there", "would", "which", "could", "really") THEN
                  @@frequencies += (word -> 1)
                END
              END;

  FOREACH (word, frequency) IN @@frequencies DO
    @@top += WordRow(word, frequency);
  END;
  PRINT @@top AS FrequentWords;
}
split) and no list-unnesting clause
(UNWIND) with which to expand the words of a review into rows.
Q38. Movies Most Frequently Called "Boring", "Disgusting", etc.
This query counts reviews containing negative keywords (e.g., 'boring', 'disgusting', 'waste') for each movie to identify those with the most negative feedback.
CREATE OR REPLACE DISTRIBUTED QUERY q38_movies_with_negative_reviews()
FOR GRAPH mlgenome SYNTAX V3 {
  SELECT m.title AS Movie, COUNT(*) AS NegativeMentions INTO result
  FROM (m:MLG_Movie)-[:MLG_HAS_REVIEW]->(r:MLG_Review)
  WHERE lower(r.text) LIKE "%boring%"
     OR lower(r.text) LIKE "%disgusting%"
     OR lower(r.text) LIKE "%waste%"
     OR lower(r.text) LIKE "%terrible%"
     OR lower(r.text) LIKE "%bad%"
  GROUP BY m.title
  ORDER BY NegativeMentions DESC;
  PRINT result;
}
Equivalent query in GQL standard:
MATCH (m:mlgenome_movie)-[:mlgenome_has_review]->(r:mlgenome_review)
WHERE toLower(r.text) CONTAINS 'boring'
OR toLower(r.text) CONTAINS 'disgusting'
OR toLower(r.text) CONTAINS 'waste'
OR toLower(r.text) CONTAINS 'terrible'
OR toLower(r.text) CONTAINS 'bad'
WITH m.title AS Movie, count(*) AS NegativeMentions
RETURN Movie, NegativeMentions
ORDER BY NegativeMentions DESC
LIMIT 10
Q39. Users With Highest MLG_Survey Agreement Accuracy
This query ranks users by how closely their survey ratings align with the consensus ratings for each tag, highlighting the most consistent/accurate survey responders.
CREATE OR REPLACE DISTRIBUTED QUERY q39_user_survey_agreement(UINT p_min_answers = 10)
FOR GRAPH mlgenome SYNTAX V1 {
  AvgAccum @consensus;
  AvgAccum @avg_deviation;
  SumAccum<INT> @answer_count;
  ListAccum<VERTEX> @answering_users;
  surveys = {MLG_Survey.*};
  users = {MLG_User.*};

  consensus_pass = SELECT t
                   FROM surveys:s -(MLG_ABOUT_TAG:e)-> :t
                   ACCUM t.@consensus += s.score;

  answered_surveys = SELECT s
                     FROM users:u -(MLG_ANSWERED:e1)-> :s
                     ACCUM s.@answering_users += u;

  deviation_pass = SELECT t
                   FROM answered_surveys:s -(MLG_ABOUT_TAG:e2)-> :t
                   ACCUM
                     FOREACH u IN s.@answering_users DO
                       u.@avg_deviation += abs(s.score - t.@consensus),
                       u.@answer_count += 1
                     END;

  result = SELECT u FROM users:u
           WHERE u.@answer_count >= p_min_answers
           ORDER BY u.@avg_deviation ASC;
  PRINT result[result.user_id AS User,
               round(result.@avg_deviation, 2) AS AvgTagDisagreement,
               result.@answer_count AS AnswerCount];
}
Equivalent query in GQL standard:
MATCH (u:mlgenome_user)-[:mlgenome_answered]->(s:mlgenome_survey)-[:mlgenome_about_tag]->(t:mlgenome_tag)
WITH u.user_id AS User, t.tag AS Tag, s.score AS UserScore
MATCH (s2:mlgenome_survey)-[:mlgenome_about_tag]->(t)
WHERE s2.score IS NOT NULL
WITH User, Tag, UserScore, avg(s2.score) AS Consensus
WITH User, avg(abs(UserScore - Consensus)) AS AvgDeviation, count(*) AS Count
WHERE Count >= 10
RETURN User, round(AvgDeviation, 2) AS AvgTagDisagreement, Count
ORDER BY AvgTagDisagreement ASC
LIMIT 10